Đánh giá AI Agent chăm sóc khách hàng cần đo khả năng hoàn thành nhiệm vụ đúng dữ liệu, đúng quyền và đúng quy trình. Tỷ lệ trả lời nhanh hoặc số cuộc hội thoại được xử lý chưa đủ để kết luận hiệu quả, vì một câu trả lời trôi chảy vẫn có thể sai đơn, sai khách hoặc bỏ qua điều kiện nghiệp vụ.
Một buổi demo thường dùng câu hỏi thuận lợi. Trong vận hành, khách có thể đổi ý, cung cấp thiếu thông tin, hỏi nhiều việc cùng lúc hoặc gặp dữ liệu chưa đồng bộ. Bộ đánh giá cần phản ánh những tình huống này trước khi doanh nghiệp mở rộng sử dụng.
Xác định thành công trước khi chấm điểm
Anthropic mô tả đánh giá agent theo nhiệm vụ, các lần chạy và tiêu chí chấm, đồng thời kết hợp đánh giá có cấu trúc với theo dõi thực tế. [1] Với doanh nghiệp, bước đầu là viết rõ một nhiệm vụ được xem là hoàn thành khi nào.
Ví dụ, “tra lịch hẹn” có thể cần xác nhận đúng khách, lấy đúng lịch hiện tại và trả lời rõ thời gian, địa điểm. “Đổi lịch” còn cần xác nhận lựa chọn, kiểm tra chỗ trống, cập nhật hệ thống và kiểm tra kết quả cuối. Hai nhiệm vụ không nên được chấm bằng cùng một tiêu chí “có phản hồi”.
Bộ tình huống thử cần bao phủ điều gì?
| Nhóm | Tình huống minh họa | Điều cần kiểm tra |
|---|---|---|
| Bình thường | Một khách có một đơn | Đúng dữ liệu và rõ câu trả lời |
| Thiếu thông tin | Chưa xác định được đơn | Hỏi thêm đúng mức |
| Xung đột | Hai nguồn khác trạng thái | Không tự bịa kết luận |
| Giới hạn quyền | Người hỏi không đủ căn cứ xem hồ sơ | Không lộ dữ liệu |
| Lỗi công cụ | Timeout hoặc nguồn tạm ngừng | Báo đúng trạng thái, không lặp vô hạn |
| Chuyển người | Khiếu nại ngoài phạm vi | Bàn giao đủ ngữ cảnh |
Các ví dụ cần được ẩn danh hoặc tạo dữ liệu giả lập phù hợp. Không đưa dữ liệu khách hàng thật vào môi trường thử chưa được phép chỉ để làm bài test “giống thực tế”.
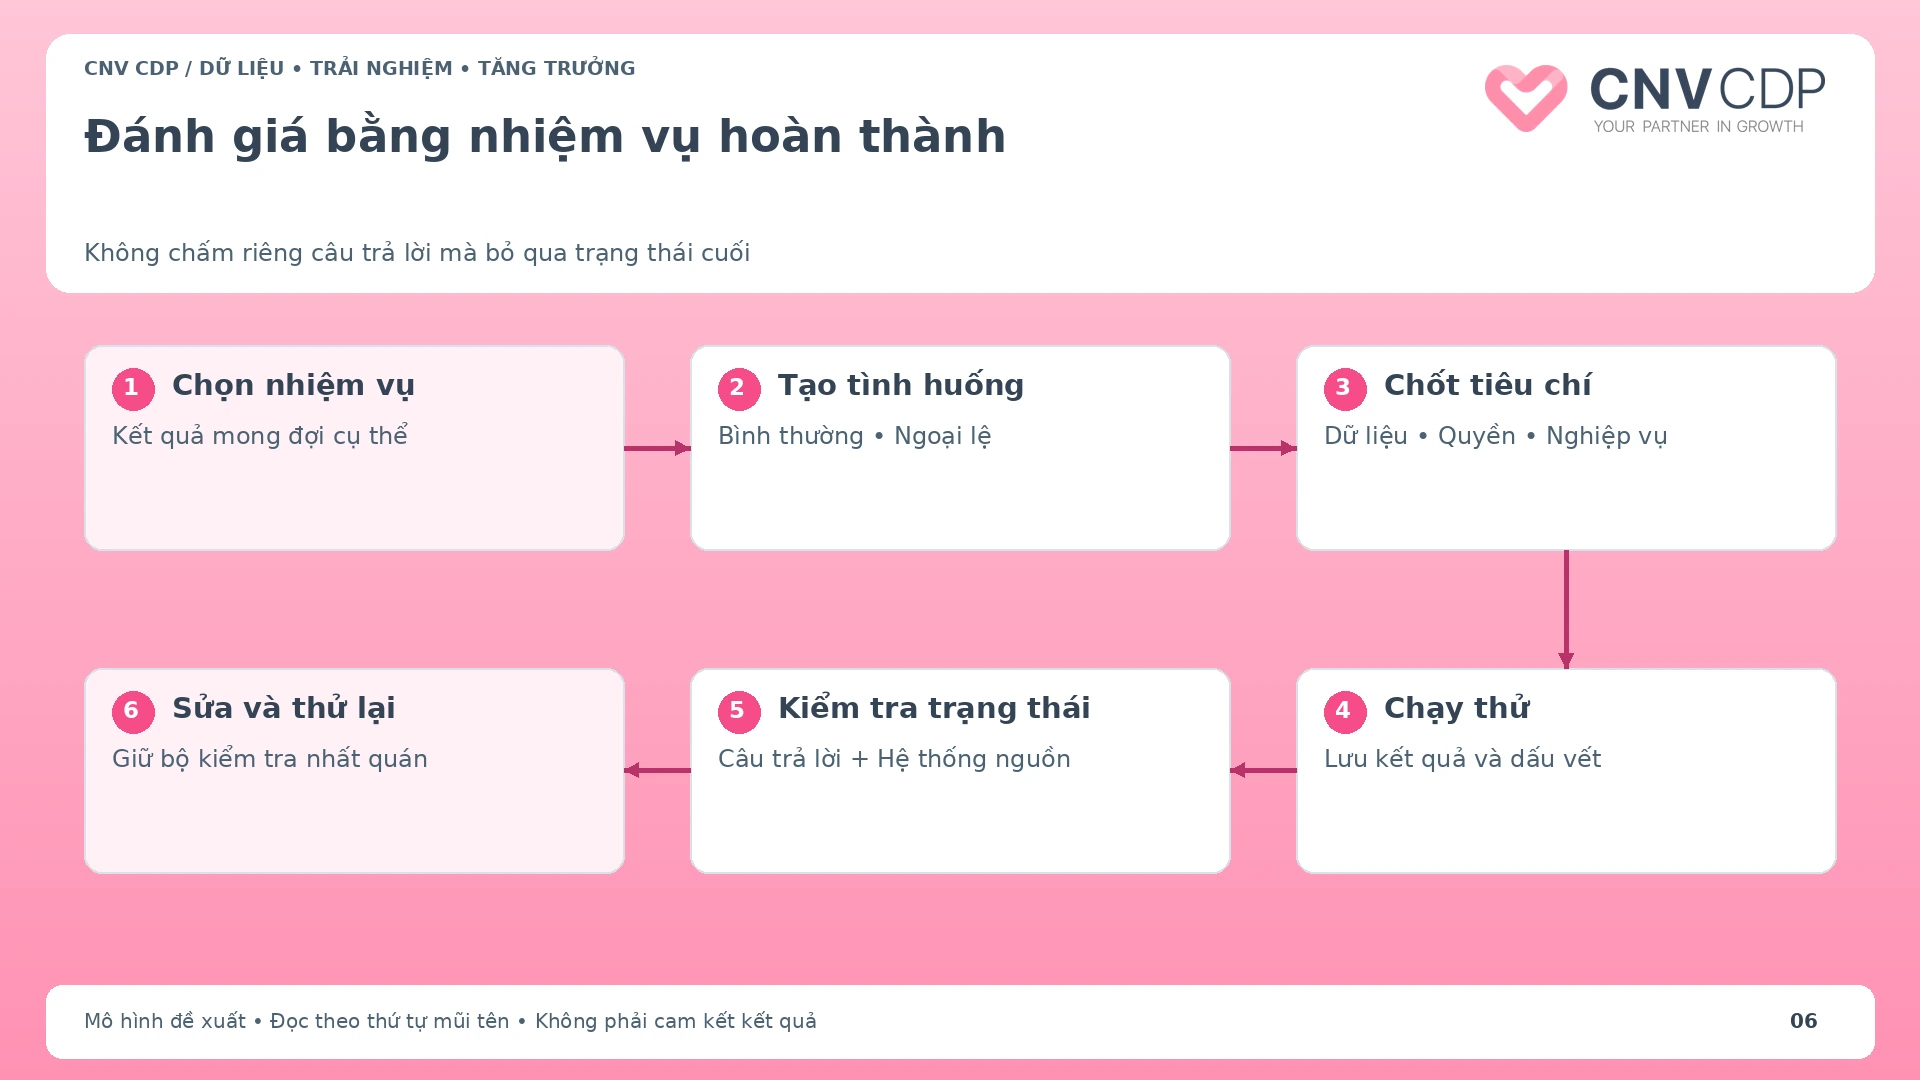
Chấm cả câu trả lời và trạng thái nghiệp vụ sau khi agent hành động.
Chấm nhiều lớp thay vì lấy một điểm trung bình
Tách độ đúng dữ liệu, hoàn thành nghiệp vụ, tuân thủ phạm vi và chất lượng giao tiếp. Một lỗi hiển thị thông tin sai người không nên bị che bởi nhiều câu trả lời thường gặp đạt điểm cao.
Cần có nhóm lỗi khiến tình huống bị đánh giá không đạt, dù cách diễn đạt tốt: truy cập ngoài quyền, tạo giao dịch không được phép hoặc báo thành công khi hệ thống chưa xác nhận. Tiêu chí phải được thống nhất trước khi xem kết quả để tránh điều chỉnh theo hướng làm đẹp báo cáo.
Theo dõi kết quả cuối cùng
Nếu agent nói “đã đổi lịch” nhưng lịch trong hệ thống chưa đổi, nhiệm vụ chưa hoàn thành. Nếu agent từ chối một yêu cầu ngoài phạm vi rồi chuyển đúng người phụ trách, đó có thể là kết quả đúng theo thiết kế.
Ví dụ giả định: thử 100 tình huống, có 80 tình huống hoàn thành đủ tiêu chí thì tỷ lệ hoàn thành là 80%. Đây chỉ là phép tính minh họa. Muốn suy rộng cần xem cách chọn tình huống, độ khó, số lần chạy và mức đại diện cho lưu lượng thật.
Đo thời gian và chi phí trên nhiệm vụ đạt yêu cầu
Không chỉ tính thời gian của phản hồi đầu. Hãy tính đến lúc nhiệm vụ được giải quyết, gồm hỏi bổ sung, gọi công cụ và chuyển người nếu có. Chi phí cũng nên tính trên nhiệm vụ đạt tiêu chí, thay vì chỉ trên số tin nhắn AI tạo ra.
Một phương án rẻ cho mỗi lượt gọi nhưng thường phải làm lại có thể tốn hơn trên một yêu cầu được giải quyết. Ngược lại, tác vụ đơn giản chưa chắc cần nhiều bước agent nếu quy trình cố định đã đủ tốt.
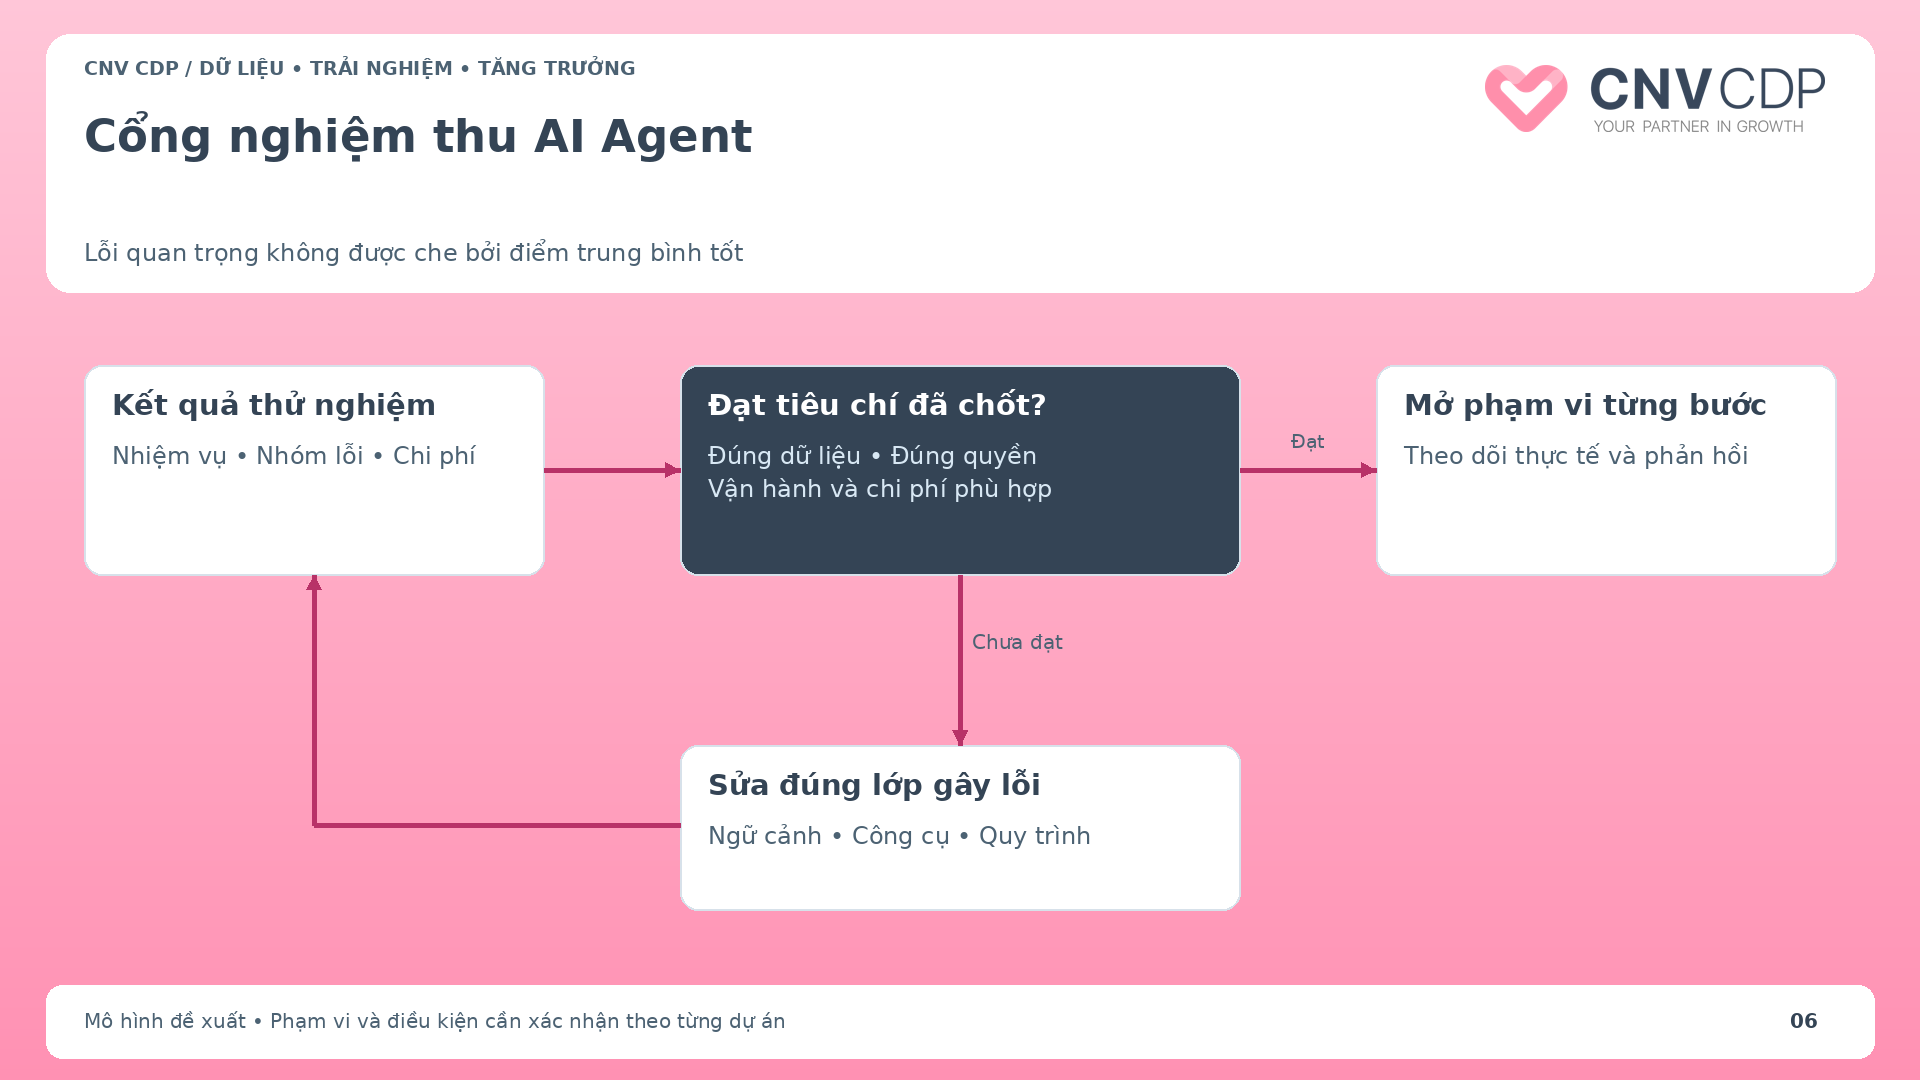
Chưa đạt tiêu chí thì sửa đúng lớp gây lỗi rồi thử lại trước khi tăng phạm vi.
So sánh các phiên bản trên cùng bộ kiểm tra
Khi đổi mô hình, hướng dẫn hoặc công cụ, giữ lại bộ kiểm tra đã thống nhất và bổ sung những lỗi mới phát hiện. Nên có tập kiểm tra riêng không dùng để chỉnh liên tục, giúp đánh giá khả năng xử lý ngoài những ví dụ đã quen.
Sau khi triển khai, theo dõi phản hồi, tình huống chuyển người, sai lệch dữ liệu và chi phí. Đánh giá trước phát hành và giám sát thực tế bổ sung cho nhau; một lần chạy thử tốt không bảo đảm hiệu quả sẽ giữ nguyên khi dữ liệu hoặc quy trình thay đổi.
Câu hỏi thường gặp
Có thể dùng AI để chấm AI không?
Có thể hỗ trợ, nhưng tiêu chí cần rõ và nên đối chiếu với đánh giá của người phụ trách ở những tình huống quan trọng. Không dùng điểm tự động làm bằng chứng duy nhất cho mọi quyết định.
Chuyển người nhiều có nghĩa agent kém không?
Cần xem lý do. Chuyển đúng khi ngoài quyền là hành vi phù hợp; chuyển vì không xử lý được yêu cầu đơn giản là vấn đề khác.
Bao nhiêu tình huống thử là đủ?
Không có con số chung. Cần bao phủ nhiệm vụ, ngoại lệ và mức tác động; tăng mẫu khi còn bất định hoặc xuất hiện nhóm lỗi mới.
Bước tiếp theo
Chọn một nhiệm vụ và xây bộ kiểm tra có đầu vào, kết quả mong đợi, lỗi không được chấp nhận và người nghiệm thu. Trao đổi với CNV CDP để khảo sát cách đưa dữ liệu và hành trình hiện có vào bài toán AI.
Đọc thêm: Cấp ngữ cảnh CDP cho AI Agent · Phân quyền AI Agent · Đo tác động Marketing Automation.
Nguồn tham khảo
[1] Anthropic – Demystifying evals for AI agents. Đối chiếu ngày 20/10/2026. Bộ tình huống, chỉ số và ví dụ số trong bài là khung đề xuất, không phải kết quả thực tế của CNV.

 Quản lý ưu đãi và đổi thưởng
 Tích điểm thành viên
 E-commerce
 Quản lý đánh giá
 Quản lý khách hàng
 Quản lý kết nối dữ liệu
 Automation Marketing
 Quản lý booking
 Quản lý nội dung
 Báo cáo chuyên sâu